
Boucles de feedback et agents IA : j’ai testé le cycle 100 % automatisé
Si les boucles de feedback des agents IA soulagent le lead dev, jusqu'où peut-on aller ? Peut-on remplacer complètement la relecture humaine du code par une boucle automatisée, et est-ce que ça tient ? Pour le vérifier, j'ai mené une expérimentation à titre personnel, en dehors de tout cadre client, sur un repository public.


Dans un article précédent, j’ai développé les risques de l’automatisation IA à outrance dans le développement logiciel. Ici, nous allons nous focaliser sur un projet que j’ai d'abord développé par moi-même, puis dont j’ai progressivement confié le développement à des agents, jusqu'à un cycle entièrement automatisé, où la relecture du code repose uniquement sur des agents et des contrôles automatiques.
Les boucles de feedback : suivre le rythme de l'IA
Un agent produit plus vite qu'un humain ne relit. Si la seule vérification est la lecture du diff par un lead dev, il devient le goulot d'étranglement, puis le maillon faible : on finit par approuver sans vraiment lire. Les boucles de feedback sont là pour partager cette charge. Elles vérifient automatiquement tout ce qui peut l'être, le plus tôt possible dans le cycle, exactement comme les contrôles qualité répartis tout au long d'une chaîne de production. Le lead n'a plus à tout porter seul, et toute l'équipe profite des mêmes garde-fous pour garder un niveau de qualité constant.
Dans ce projet, il y a ainsi quatre boucles, de la plus rapide à la plus lente :
- À chaque modification de fichier, un hook Claude Code lance les contrôles de conventions et ESLint, et renvoie les erreurs directement à l'agent.
- À chaque commit et push, des hooks Git lancent la suite complète : lint, typecheck, tests, détection de duplication et de code mort.
- Sur chaque PR, la CI relance tout, et un agent de review vérifie ce que les outils ne voient pas : design system, textes, architecture.
- Sur l'environnement de recette, un dernier agent teste l'application dans un navigateur, sur mobile et desktop, en thème clair et sombre.
Les tests sont la boucle la plus rentable. Ce qu'un test fige, l'agent ne peut pas le casser sans que ça se voie. C'est pourquoi une règle du projet impose qu'une correction de bug arrive toujours avec un test qui échoue sans elle.
La review par agent ne remplace pas la vôtre, elle la filtre. Un second agent, sans le contexte du premier, repère une bonne partie des oublis : un composant dupliqué, une couleur codée en dur. Votre review peut alors porter sur l'essentiel : est-ce la bonne fonctionnalité, et le bon compromis ?
Plusieurs agents spécialisés, c'est encore mieux. Plutôt qu'un seul reviewer généraliste, on peut confier à chaque agent son propre sujet : l'interface, le fonctionnel, l'UXL'UX signifie "user experience" et définit l'ensemble des éléments permettant l'utilisation du site web de façon optimale., la qualité du code, ou même un agent qui ne s'intéresse qu'aux petits détails. C'est très efficace quand on a une crainte précise, qu'on veut se prémunir contre certains défauts ou faire respecter des guidelines particulières. Et chaque agent n'a pas besoin du même modèle : on adapte son niveau à la complexité de sa tâche et au contexte dont il a besoin.
Attention, ces agents de review ne font pas monter sur l'échelle présentée plus haut. Un agent qui relit et commente, sans écrire de code, est une boucle de feedback compatible avec tous les niveaux. Ce qui caractérise le dernier niveau, c'est un agent qui développe lui-même en CI, à partir d'un ticket.
Une base de code saine : des règles vérifiées par la machine
À chaque session, un agent arrive sur votre projet sans aucune mémoire. Il ne connaît ni vos conventions, ni les erreurs déjà commises, ni la raison d'être de tel ou tel module. La documentation n'est donc plus un bonus pour les nouveaux arrivants : c'est l'onboarding de chaque session, l'équivalent des procédures et des fiches de poste d'une usine.
L'étape la plus importante se joue dès le départ. La plupart de ceux qui travaillent avec des agents s'accordent sur ce point : mettre en place un environnement d'instructions solide (un CLAUDE.md ou équivalent) dès le début du projet, avant que les mauvaises habitudes ne s'installent dans le code. Un agent reproduit ce qu'il voit : sur une base saine, il produit du code sain.
Un seul fichier de règles
Le premier réflexe est souvent de tout écrire dans un seul gros fichier d'instructions, qui grossit à chaque problème rencontré. Mais un agent ne lit pas vraiment des centaines de règles, et surtout, rien ne l'y oblige.
Mieux vaut un fichier de règles unique et court (un AGENTS.md, par exemple), partagé par tous les agents. Il liste notamment les briques existantes à réutiliser, le meilleur remède à la tendance des agents à réécrire ce qui existe déjà. Le fonctionnement détaillé et les règles visuelles vivent dans des documents séparés, lus uniquement quand l'agent touche à la zone concernée.
L'effet cliquet : toute règle finit dans la CI
Une règle écrite en prose est à une review de régresser. D'où le principe du cliquet : quand une review (humaine ou agent) trouve une règle enfreinte que la CI n'a pas détectée, la même PR ajoute le contrôle qui l'aurait détectée. Concrètement, un script applique aujourd'hui 18 règles propres au projet (pas de couleur hors du design system, pas de texte sous 12 px, etc.), en plus d'ESLint, de TypeScriptLangage de programmation basé sur JavaScript. strict et d'une détection de code dupliqué.
Enfin, certaines règles ne se vérifient que dans un navigateur. Une interface peut passer tous les contrôles et casser malgré tout le design system à l'écran. Un contrôle de mise en page ouvre donc Chrome en largeur mobile et mesure le scroll horizontal, la taille des textes et celle des champs : sa première exécution a trouvé sept champs trop petits.
Un cycle basé sur cinq workflows Github Actions et Claude Code
Pour filer la métaphore, ce projet fonctionne comme une petite usine automatisée : je n'y suis plus l'artisan, mais celui qui conçoit la chaîne et contrôle ce qui en sort. Mon rôle se résume ici à trois gestes : écrire un ticket, poser un label, merger. Entre les deux, cinq workflows GitHub Actions s'appuient sur Claude Code :
- Implémenter. Le label
ready-for-devsur un ticket lance un agent qui écrit le code et les tests, ouvre la PR et déploie une release candidate en recette. S'il manque une décision, il pose ses questions dans le ticket et s'arrête. - Relire le diff. À chaque push, un agent de review ajoute le contrôle manquant, corrige ce qui est sûr, ou me laisse un commentaire.
- Relire le rendu. Un autre agent navigue dans l'environnement de recette, sur mobile et desktop, en clair et en sombre.
- Réparer la CI. Si un contrôle échoue, un agent dédié corrige la cause, sans jamais ajouter d'exemption.
- Répondre à la review. Un commentaire
@claudede ma part relance un agent qui traite les retours.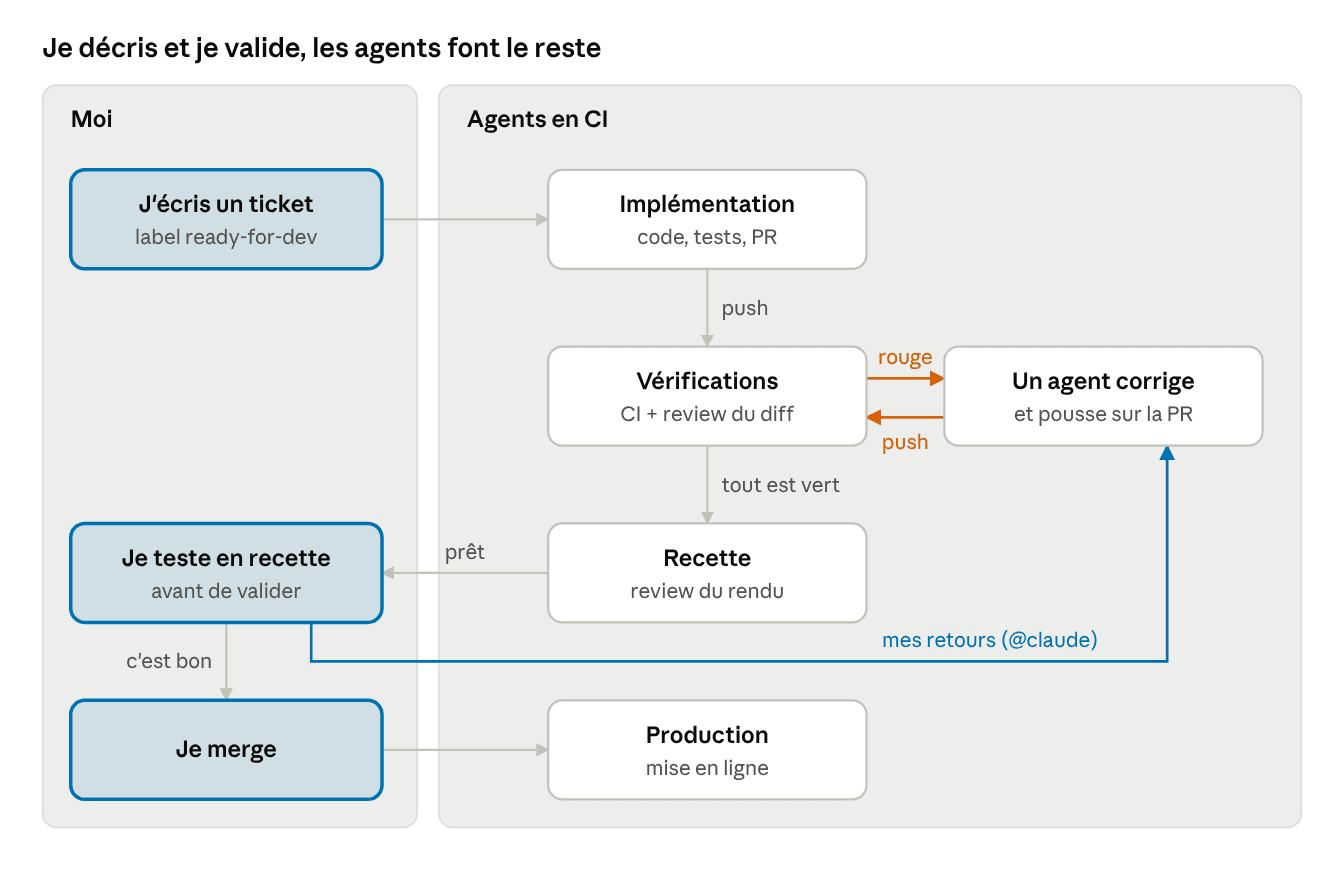
Les cases en couleur sont les seuls moments où j'interviens, tout le reste tourne en CI. Il ne me reste plus qu'à tester en recette, commenter pour demander des modifications et merger quand le résultat me convient.
Boucles de feedback : qu'est-ce que ça apporte ?
-
Le débit ! Une fonctionnalité complète passe du ticket à la recette sans que je touche au clavier, et plusieurs tickets peuvent avancer en parallèle.
-
Une meilleur gestion du temps qui se déplace vers le produit. Je passe l'essentiel de mon temps à définir ce que je veux et à juger le résultat, ce qui est exactement là où j'apporte de la valeur.
-
La qualité augmente avec le temps. Grâce à l'effet cliquet, chaque erreur ne se produit qu'une fois : la base de contrôles grossit à chaque review.
-
Enfin, un coût quasi nul. Toute cette chaîne repose sur des offres gratuites : le repo étant public, les runners et le stockage de GitHub ne coûtent rien. S'y ajoutent seulement un abonnement IA à 20 € par mois et un compte AWS qui revient à moins d'un euro par mois, hors nom de domaine. Le site est en effet hébergé sur le plan gratuit de CloudFront, que nous avons détaillé dans un précédent article.
Ce que coûte l’automatisation du feedback via des agents IA
Le développement et la maintenance de l'orchestration deviennent une préoccupation plus importante. Mes derniers commits portent presque tous sur les workflows, pas sur l'application : chaque incident (deux agents sur la même branche, un token qui expire en pleine tâche) a demandé un verrou, un garde-fou ou un nouveau secret.
Un agent peut tenter de contourner des limites silencieusement, et introduire de mauvaises pratiques ou des failles. Bloqué par un droit manquant sur le repo du dataset, un agent l'a tout simplement recopié dans le repo principal pour avancer. Le code passait, l'architecture beaucoup moins. Il faut donc rester vigilant sur l'architecture, et sur les failles auxquelles on pourrait s'exposer.
Vert ne veut pas dire juste. Plusieurs PR étaient correctes côté application mais pointaient vers des données pas encore mises à jour : tout était vert, et la recette n'affichait rien.
Enfin, la connaissance du code s'érode. Je connais très bien les règles et l'architecture du projet, beaucoup moins le détail de chaque module. C'est un choix assumé sur un projet personnel, mais pas un modèle à transposer tel quel sur un projet client.
Alors, le code review automatisé, est-ce que ça tient ?
Oui, en tout cas sur ce projet. Le résultat est une application d'apprentissage du japonais en production, fonctionnelle et utilisable au quotidien, sans relecture humaine systématique du code avant la recette. Les boucles de feedback automatisées sont donc une aide bien réelle, capable d'absorber une grande partie de la review.
La leçon principale est ailleurs : le degré de contrôle humain nécessaire varie selon le contexte. Sur un projet personnel, on peut se contenter de la recette et du merge. Sur un projet client, les boucles de feedback allègent la charge du lead dev, mais ne remplacent pas sa relecture sur les parties critiques.
Pour ceux qui voudraient regarder de plus près, le code est public sur GitHub, workflows et AGENTS.md compris.
Retour d’expérience : ce qu'il faut faire et ce qu'il faut éviter
Avec un peu de recul, voici les principales leçons que je retire de ce projet :
À faire
- Choisir le niveau d'autonomie selon le contexte, et garder la production hors de portée de l'agent.
- Poser un fichier d'instructions solide dès le début du projet, puis le faire évoluer avec lui.
- Appliquer le principe du moindre privilège aux tokens des agents : un token par usage, limité au repo et aux seules actions nécessaires. C'est ce qui protège le projet le jour où un agent se trompe.
- Transformer chaque règle en contrôle automatique, et chaque erreur trouvée en review en un nouveau contrôle.
- Vérifier le rendu réel, pas seulement la CI.
- Continuer à lire et à comprendre les parties critiques : la sécurité, les données, la facturation.
À éviter
- Corriger une CI rouge en assouplissant une règle, que ce soit vous ou l'agent.
- Approuver un diff que vous n'avez pas compris parce que "les tests passent".
Au final, faut-il confier la relecture de son code à des agents IA ?
C'est possible, mais à ne pas faire les yeux fermés ! La chaîne tient, mais l’agent qui recopie un dataset pour se débloquer rappelle qu’il fait ce qu’on lui demande, pas forcément ce qu’on voulait. Automatisez la boucle, mais gardez la main sur la sécurité, les données et la facturation. Et vous, où placez-vous le curseur ?
Nos podcasts en lien

Pour aller plus loin
Les performances en Java Spring boot : comment les optimiser ?
Comprendre les performances en Java Springboot et les optimiser.

Projet JEE 7 sans hibernate ni JPA
Dans cet article, nous allons étudier la possibilité de créer un projet JEE 7 classique mais en supprimant la partie JPA / Hibernate.
Big Data et SOA : Combo Gagnant ?
Est ce que le Big Data le SOA est le combo gagnant ?


Nous suivre, nous écouter