
Agents IA : jusqu'où automatiser le développement sans perdre le contrôle ?
En développement, l'IA est passée en très peu de temps de l'autocomplétion à des agents capables de lire tout un projet, de lancer des commandes et d'ouvrir des pull requests seuls. Et plus on donne d'accès et d'outils à des agents IA, plus on va vite, mais en contrepartie, on prend aussi plus de risques.


Le débat oppose souvent ceux qui "n'y croient pas" et ceux qui "ne codent plus". En réalité, l'IA est un levier pour augmenter la productivité, mais au coût d'une maîtrise précise. Elle est, comme à l'époque de l'industrialisation, un équivalent de la machine outil ou de la chaîne de production, remplaçant petit à petit le travail manuel et artisanal. Certes, les artisans du code possèdent une maîtrise de leur art plus fine et précise que l'ouvrier opérant une machine outil. Mais l'ouvrier, en utilisant de l'énergie, produit beaucoup plus rapidement un produit de qualité raisonnable.
Dans cet article, nous allons voir comment adapter l'usage de l'IA au contexte, quels sont les vrais risques, et pourquoi les tests, les reviews et une base de code saine deviennent indispensables. Bonne lecture !
IA : la première machine qui s’attaque au coût de l’intelligence
Jusqu'ici, chaque révolution industrielle s'est attaquée à la même ressource : l'énergie physique. La machine à vapeur, puis le charbon et le pétrole, ont rendu la force musculaire humaine presque dérisoire face à celle des machines. L'intelligence, elle, est restée la ressource la plus chère : longue à former, impossible à stocker, et disponible en quantité limitée. L'IA est la première machine qui s'attaque à ce coût-là. Et le développement logiciel, un métier fait presque uniquement d'intelligence, se retrouve donc en première ligne.
Cependant, l'histoire industrielle nous apprend aussi qu'une machine seule ne suffit pas. Il a fallu des contrôles qualité en sortie de chaîne, des normes, des protections autour des machines. Il en va de même avec l'IA : ce qui fait la différence, ce n'est pas tant le modèle que ce que l'on construit autour, à savoir les tests, les reviews, les règles écrites et vérifiées automatiquement.
Les différents niveaux d'usage de l'IA : projets clients vs projets persos
L'IA en développement n'est pas un outil unique, c'est plutôt une échelle, un peu comme le passage de l'outil à main à la machine-outil, puis à la chaîne automatisée. À chaque marche, on lui confie davantage : du contexte, puis des fichiers, puis des commandes, puis des environnements. Le gain de vitesse suit, le risque aussi.
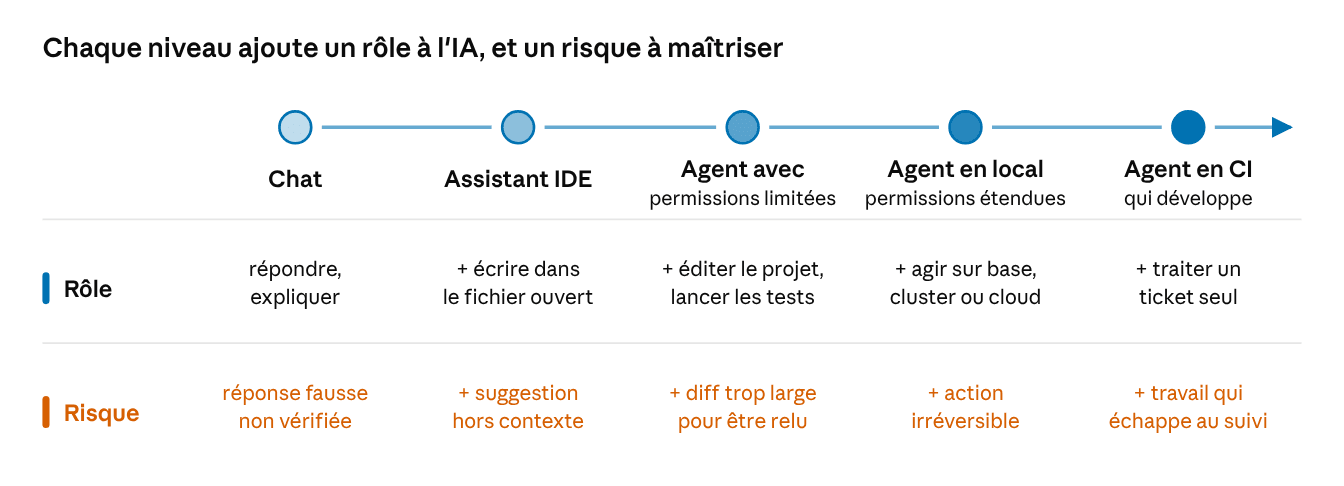
Sur un projet client, mieux vaut rester plus bas sur l'échelle. Le code appartient au client, les environnements sont partagés, et une erreur ne coûte pas que votre temps. L'agent peut très bien travailler dans le repo, mais pas en production : par exemple, il modifie les templates et les values Helm, mais ne lance jamais une commande contre le cluster de production. Ce n'est pas une question de confiance dans le modèle, c'est une question de périmètre.
Sur un projet personnel, en revanche, on peut aller jusqu'en haut. Personne d'autre ne subit les erreurs, les données sont reconstructibles, et c'est justement le bon endroit pour mesurer ce qu'un cycle entièrement automatisé apporte, et ce qu'il coûte.
Agents IA : les risques que l'on sous-estime
Prêter ses accès à un agent IA
Tout d'abord, un agent qui peut lancer des commandes agit avec vos droits. S'il a accès à un terminal connecté à la production, à un token GitHub avec droit de push ou à un compte cloud, chacune de ses erreurs devient la vôtre. Et un agent se trompe avec beaucoup d'aplomb : il n'hésite pas avant un DROP, un push --force ou une suppression de ressource.
Le modèle n'est pas le seul danger. En effet, un agent lit aussi des tickets, des pages web, des logs de CI. Un texte malveillant dans l'un d'eux peut l'amener à faire autre chose que ce que vous lui avez demandé (c'est ce qu'on appelle la prompt injection). Plus l'agent a d'outils, plus cette surface d'attaque compte.
Comme les carters et les arrêts d'urgence sur une machine industrielle, quelques règles simples permettent de limiter la casse :
- des droits minimaux et dédiés : un token par usage, limité au repo et aux actions nécessaires ;
- pas d'accès direct à la production : l'agent modifie le code d'infrastructure, un humain ou une pipeline l'applique ;
- des actions irréversibles soumises à confirmation, et une liste explicite des commandes autorisées sans validation.
Prêter la propriété du code à un agent IA
Le second risque est plus insidieux. Plus un développeur délègue à l'IA, moins il sait ce qui a été écrit et comment ça fonctionne vraiment. Relire un diff n'est pas l'écrire : on valide une intention, rarement chaque cas limite. Au bout de quelques semaines, on se retrouve donc propriétaire d'un code que l'on n'a jamais vraiment eu en tête. C'est la contrepartie de la machine : l'ouvrier sur la chaîne produit beaucoup plus, mais il ne sait plus forcément fabriquer la pièce de bout en bout comme l'artisan.
Il n'existe pas de solution miracle. Une première piste consiste à déplacer la connaissance : du code vers des documents et des vérifications qui disent ce que le système doit faire, et qui échouent quand il ne le fait plus. Mais ce n'est qu'un levier parmi d'autres. On peut difficilement rester propriétaire d'un code que l'on n'a pas écrit, et certains en concluent qu'il faut encadrer, voire limiter, l'usage de l'IA en entreprise.
Encore faut-il que cette limite soit encouragée. Vu de l'extérieur, un développeur qui code avec l'IA a tout pour plaire à un manager : il va plus vite, répond à davantage de demandes clients, et livre une documentation et des tests soignés. La différence ne se voit qu'en regardant de près. Un lead technique la repère, mais un développeur junior qui ne connaît pas encore certains pièges risque de ne pas relire son code ni vérifier ce que les tests couvrent vraiment, avec des conséquences parfois sérieuses.
C'est pourquoi l'IA ne dispense pas d'accompagner les équipes : la review par un développeur expérimenté, et le temps laissé pour comprendre ce qui a été produit, restent des garde-fous à part entière. Mais cela a un coût : la charge retombe sur les développeurs expérimentés. Avec le gain de productivité, un lead dev qui relit tout peut vite se retrouver avec dix fois plus de code à valider.
Au final, où placer le curseur de l'automatisation IA ?
L'IA ne rend pas les bonnes pratiques optionnelles, elle les rend indispensables. Tests, reviews, conventions, documentation : tout ce qu'une équipe repoussait "pour plus tard" devient la condition pour suivre le rythme d'un agent sans perdre le contrôle du code.
C'est là que le métier change vraiment. Comme lors de l'industrialisation, l'artisan ne disparaît pas, il change de poste : le développeur écrit moins de code, mais il conçoit davantage le système qui le produit et le vérifie : les règles, les boucles de feedback, les limites d'accès. Plus vous montez sur l'échelle de l'autonomie, plus cet investissement compte. Et plus il faut décider, consciemment, ce que vous acceptez de ne plus savoir. Après l'énergie physique, c'est au tour de l'intelligence de devenir bon marché : à nous de construire les garde-fous qui vont avec.
Pour approfondir le sujet, j'ai rédigé un retour d'expérience sur l'un de mes projets personnels, dans lequel j'ai testé des boucles de feedback 100 % automatisées grâce à des agents IA
Nos podcasts en lien

Pour aller plus loin
Dette technique : 4 conseils pour une meilleure gestion
Comment gérer la dette technique ? On vous donne 4 conseils pratiques pour ne pas se laisser déborder !

Créer un site web en 2025 : un défi plus complexe que jamais
On ne pensait jamais dire cela, mais concevoir un site web en 2025 n'a jamais été aussi complexe ! Pourquoi ? Parce que pour respecter les meilleures pratiques actuelles, vous devez gérer un projet bien plus sophistiqué qu'il n'y paraît. Chaque détail compte pour offrir une expérience utilisateur optimale, respecter les exigences des moteurs de recherche, et garantir la conformité légale.
Utiliser intelligemment l'IA en tant que développeur : nos conseils !
"ChatGPT, peux-tu écrire un article sur l'évolution de l'IA et comment utiliser les outils d'IA en tant que développeur ?" Rassurez-vous, cet article est bien rédigé par un humain, avec un cœur qui bat et une passion démesurée pour le développement ! Alors si en tant que développeur, vous avez parfois des doutes sur votre manière d'utiliser l'IA, cet article va vous intéresser ! Mais tout d'abord, reprenons les bases. Quelles sont les différentes catégories d'intelligence artificielle ?


Nous suivre, nous écouter